Une vente de 100 euros fait l’objet de deux remboursements partiels. Pour calculer le solde, vous joignez les lignes de vente aux événements de remboursement. La requête fonctionne. Mais la vente apparaît deux fois, et sa somme passe à 200 euros.
Ce cas fictif est le point de départ de notre atelier. Un schéma en étoile devient fiable lorsque chaque table représente un niveau de détail explicite et que les calculs respectent ce niveau. Dessiner des tables autour d’un centre ne suffit pas.
Ce guide vous aide à construire un modèle de ventes et de remboursements, à distinguer deux lectures temporelles et à contrôler les agrégations. Télécharger l’atelier SQL et Python : quatre lignes de vente, trois remboursements et quinze contrôles exécutables, sans service cloud.
Un schéma en étoile organise les faits et leurs axes de lecture
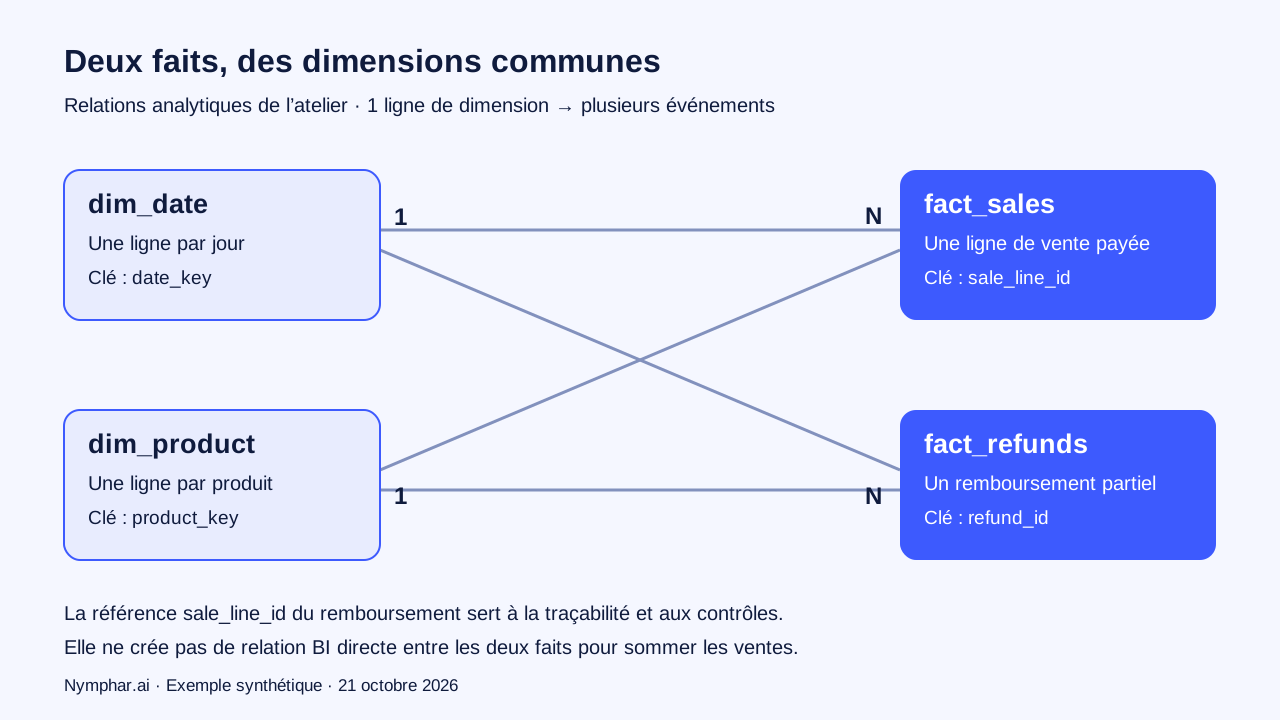
La modélisation dimensionnelle sépare les faits, qui portent les événements ou observations à analyser, des dimensions, qui décrivent les axes de filtrage et de regroupement. Dans notre cas, les faits sont les lignes de vente et les remboursements ; les dimensions communes sont le produit et la date.
Le grain répond à une phrase simple : « une ligne représente… ». Kimball place cette décision avant le choix des dimensions et des mesures. Elle évite de réunir sous un même nom des observations incompatibles. Définition du grain par Kimball.
Une commande peut contenir plusieurs lignes. Une ligne peut faire l’objet de plusieurs retours. Une table nommée ventes ne dit donc presque rien de son contenu. Une définition telle que « une ligne de commande payée, identifiée par son identifiant de ligne » permet de discuter les clés, les montants et les cas limites.
Le modèle dimensionnel prépare les données. Les règles de calcul et leur exposition aux utilisateurs relèvent ensuite du modèle sémantique. Les deux sujets se complètent : partager une formule ne corrige pas une table qui répète ses événements.
Définir les deux faits avant de les rapprocher
Pour l’exercice, nous retenons uniquement des ventes payées, en euros, hors taxes, après remise et hors frais de port. Les montants sont stockés en centimes entiers. Les remboursements sont des montants positifs que le calcul retranche. Ce « solde » pédagogique n’est pas une définition comptable universelle.
| Table |
Une ligne représente |
Identifiant |
Date utilisée |
fact_sales |
Une ligne de vente payée |
sale_line_id |
Date de vente |
fact_refunds |
Un remboursement partiel d’une ligne |
refund_id |
Date du remboursement |
dim_product |
Un produit dans ce modèle sans historique |
product_key |
Sans objet |
dim_date |
Une journée du calendrier de l’exercice |
date_key |
Jour civil |
Le remboursement conserve sale_line_id pour retrouver sa vente d’origine. Cette référence sert à vérifier son attribution. Elle n’autorise pas à additionner les ventes après une jointure avec tous les retours.
Dans un modèle BI, les dimensions communes filtrent chacun des deux faits. La relation attendue va d’une ligne de dimension vers plusieurs lignes de fait. Microsoft décrit cette séparation entre tables utilisées pour filtrer ou regrouper et tables utilisées pour agréger. Guide du schéma en étoile pour Power BI.
Notre schéma téléchargeable représente ces relations analytiques. La référence de traçabilité entre remboursement et vente reste distincte.
Reproduire le double compte sur sept événements
Le jeu synthétique contient les opérations suivantes :
| Vente |
Commande |
Produit |
Date |
Montant HT |
| L1 |
C1 |
P1 |
1er octobre |
100 EUR |
| L2 |
C1 |
P2 |
1er octobre |
60 EUR |
| L3 |
C2 |
P1 |
2 octobre |
100 EUR |
| L4 |
C3 |
P3 |
2 octobre |
40 EUR |
L1 reçoit deux remboursements : 20 EUR le 2 octobre, puis 10 EUR le 3. L3 reçoit un remboursement de 25 EUR le 3. Les ventes totalisent 300 EUR, les remboursements 55 EUR, et le solde attendu 245 EUR.
Cette requête est volontairement incorrecte :
SELECT SUM(s.amount_cents)
       - SUM(COALESCE(r.amount_cents, 0)) AS net_cents
FROM fact_sales s
LEFT JOIN fact_refunds r
  ON r.sale_line_id = s.sale_line_id;
Elle produit cinq lignes jointes. L1 est répétée, les ventes montent à 400 EUR et le solde faux à 345 EUR. Il ne manque aucune colonne ; le problème vient de la multiplicité des correspondances.
SUM(DISTINCT s.amount_cents) ne répare pas cette erreur. L1 et L3 sont deux ventes légitimes de 100 EUR. Dédupliquer leurs montants supprime aussi une vente réelle : dans ce jeu, le solde tombe à 145 EUR. L’identité d’un événement ne se déduit pas de sa valeur.
Combiner des agrégats au même niveau
Pour comparer les mouvements par jour et produit, nous calculons séparément les ventes et les remboursements à ce grain, puis nous combinons les deux flux. Le principe de calcul séparé rejoint la technique de rapprochement des faits décrite par Kimball ; l’implémentation avec UNION ALL ci-dessous est celle de notre atelier. Multipass SQL.
WITH movements AS (
  SELECT date_key, product_key,
         SUM(amount_cents) AS sales_cents,
         0 AS refunds_cents
  FROM fact_sales
  GROUP BY date_key, product_key
  UNION ALL
  SELECT date_key, product_key,
         0 AS sales_cents,
         SUM(amount_cents) AS refunds_cents
  FROM fact_refunds
  GROUP BY date_key, product_key
)
SELECT date_key, product_key,
       SUM(sales_cents) - SUM(refunds_cents) AS net_cents
FROM movements
GROUP BY date_key, product_key;
Le zéro signifie ici que la branche « ventes » ne porte pas de remboursement, et réciproquement. Il ne remplace pas un montant source inconnu. Les montants absents sont refusés par les contraintes de l’exercice.
UNION ALL conserve les lignes des deux ensembles ; l’agrégation finale les rapproche sur les mêmes clés. La documentation SQLite décrit le comportement des requêtes composées. Référence SELECT. Sur un autre moteur, vérifier les types et la syntaxe avant de reprendre le SQL.
Le résultat conserve notamment le 3 octobre, qui contient des retours mais aucune vente. Une requête construite uniquement à partir des journées de vente aurait pu faire disparaître cette activité.
Deux dates peuvent produire deux lectures justes
À la date de chaque événement, le solde vaut 160 EUR le 1er octobre, 120 EUR le 2 et moins 35 EUR le 3. Cette lecture répond à : « quels mouvements ont eu lieu chaque jour ? »
Pour analyser les ventes d’origine, nous rattachons les retours connus à leur ligne de vente. Le solde devient alors 130 EUR pour les ventes du 1er octobre et 115 EUR pour celles du 2. Le total reste 245 EUR, mais la question est différente : « que reste-t-il de ces ventes après les remboursements connus ? »
Le fichier cohort.sql agrège d’abord les retours par sale_line_id. Chaque vente rejoint alors au plus une ligne de remboursements agrégés. Cette jointure contrôlée est différente de la jointure brute entre événements.
Un remboursement tardif modifie la lecture par cohorte d’une période passée. Si votre rapport doit reproduire ce qui était connu à une date donnée, il faut conserver les dates de connaissance ou des versions adaptées. L’atelier utilise tous les événements fournis et ne prétend pas reconstruire un arrêté historique. Le guide des modèles incrémentaux dbt traite le problème voisin des corrections et arrivées tardives.
Trois décisions à prendre dans un vrai département data
Ventes et retours d’un commerce. Partir des lignes de commande et des événements de remboursement, définir le traitement des remises, taxes, frais et annulations, puis comparer le solde à une référence métier. Le critère de réussite est l’explication des écarts par événement et produit, pas seulement un total identique.
Objectifs mensuels et ventes quotidiennes. Un objectif à la maille mois-catégorie ne doit pas être recopié puis sommé sur chaque vente. Agréger les ventes à cette maille avant comparaison. Si l’entreprise veut répartir l’objectif par jour ou produit, écrire une règle d’allocation et vérifier que ses parts retrouvent l’objectif initial. Sans cette règle, ne pas présenter une précision inexistante.
Stock quotidien et mouvements. Un solde de stock de fin de journée est une observation à une date ; l’additionner sur plusieurs jours ne donne pas le stock final. Choisir explicitement la dernière observation disponible ou une moyenne définie pour le besoin. Kimball distingue les faits transactionnels et les instantanés périodiques ; cette distinction aide à choisir les calculs autorisés. Types de tables de faits.
Ces situations ne nécessitent pas toutes le même modèle. Elles demandent toutes une définition de la ligne et de l’agrégation attendue.
Exécuter l’atelier local
Téléchargez puis décompressez l’archive. Il suffit de Python 3.10 ou plus récent, avec son module standard sqlite3. Aucun paquet, compte ou abonnement n’est requis. L’exécution a été vérifiée avec Python 3.14.7 et SQLite 3.53.1, le 21 octobre 2026.
Depuis le dossier de l’atelier :
python3 run.py
Le programme crée une base en mémoire, charge schema.sql et data.sql, puis exécute les requêtes et les contrôles. Il affiche un JSON contenant les résultats et renvoie un code de sortie nul si tous les contrôles passent. Aucun service ne tourne ensuite ; aucune base persistante n’est créée.
Lisez successivement incorrect.sql, activity.sql et cohort.sql. Comparez leurs sorties à reference.json, qui contient les valeurs attendues écrites pour cet exemple fictif. Modifiez ensuite une donnée ou une requête et relancez le programme pour observer quel contrôle échoue.
Les quinze contrôles couvrent le total, les groupes jour-produit, les produits, la cohorte, la journée sans vente, les deux calculs incorrects, les doublons, un produit orphelin, un montant absent, une autre devise et l’attribution des retours. Ils valident cet exercice local, pas la performance d’un entrepôt ni un modèle Power BI connecté.
Contrôler les relations autant que les sommes
L’unicité de la clé côté dimension empêche qu’une même ligne de fait rencontre plusieurs lignes portant cette clé. Les références doivent aussi exister. Dans SQLite, l’application doit activer les clés étrangères pour la connexion ; le script le fait explicitement. Contraintes de clés étrangères SQLite.
Ces contrôles ne prouvent pas que le produit attribué est le bon. Le programme teste ainsi un remboursement associé à P2 alors que sa vente porte P1 : les deux produits existent, mais leur rapprochement est incohérent. controls.sql révèle cette anomalie.
Sur vos données, ajouter un rapprochement indépendant avec les événements source validés. Un total global peut rester juste malgré des montants déplacés entre produits. Comparer les clés et les valeurs par groupe, puis examiner les exceptions, protège mieux la décision métier.
Pour une dimension inconnue à l’arrivée du fait, choisir une politique explicite : mise en attente, rejet ou membre « inconnu » traçable. Une jointure interne qui élimine silencieusement la ligne fausse le périmètre. Notre exercice choisit le rejet ; il ne modélise pas la résolution ultérieure des inconnus.
Passer du prototype au modèle partagé
Le premier périmètre peut tenir dans un seul rapport. Inventoriez les tables sources, écrivez leur grain, faites valider les dates et le traitement des retours, puis contrôlez quelques cas limites avant de migrer les mesures.
Un changement de catégorie produit pose une autre question : faut-il lire une vente avec la catégorie actuelle ou celle de l’époque ? Le premier choix remplace l’attribut ; le second demande de conserver les versions et de rattacher le fait à la bonne version. Microsoft décrit ces approches de dimensions à évolution lente. Notre atelier conserve des produits fixes ; il ne teste pas leur historisation. Historique des dimensions.
L’actualisation, les droits et le partage restent des travaux à part entière. Charger ventes et retours avec des coupures cohérentes, afficher la fraîcheur, tester les filtres avec les rôles réels et publier les mesures dans le circuit BI existant. Aucune configuration de permissions n’est créée par le schéma SQL.
La méthode n’impose pas l’achat d’un outil. Le coût d’adoption vient surtout de la compréhension des sources, des transformations, de la reprise des rapports et de leur maintenance. Les licences et capacités de votre plateforme restent à évaluer selon votre déploiement ; aucun tarif cloud n’entre dans l’atelier local.
Mesurez le temps nécessaire pour expliquer un écart, le nombre de calculs locaux conservés et les résultats des contrôles après actualisation. Un petit export à grain unique peut rester suffisant pour une analyse ponctuelle. Dès que plusieurs faits, dates ou consommateurs se croisent, une modélisation explicite rend ces choix plus faciles à vérifier.