Votre assistant retrouve le plafond ordinaire d’une note de frais, mais sa réponse oublie l’exception applicable pendant un salon. Agrandir les passages paraît logique. Pourtant, l’exception peut déjà se trouver dans le deuxième résultat, ou disparaître plus tard lorsque le contexte est limité.
Pour régler le chunking d’un RAG, examinez les preuves qui arrivent après le classement et la limite de contexte. Le premier passage retrouvé ne suffit pas à diagnostiquer une perte d’information. Un passage plus grand ne garantit pas non plus que davantage de faits seront conservés.
Ce tutoriel fournit un atelier local exécuté sur trois documents français fictifs. Il découpe réellement le texte, lance une recherche lexicale SQLite FTS5, puis mesure les portions de preuve conservées. Aucun embedding ni modèle génératif n’est utilisé : nous évaluons l’entrée documentaire possible d’un RAG, pas la justesse de ses réponses.
Le découpage change l’unité retrouvée
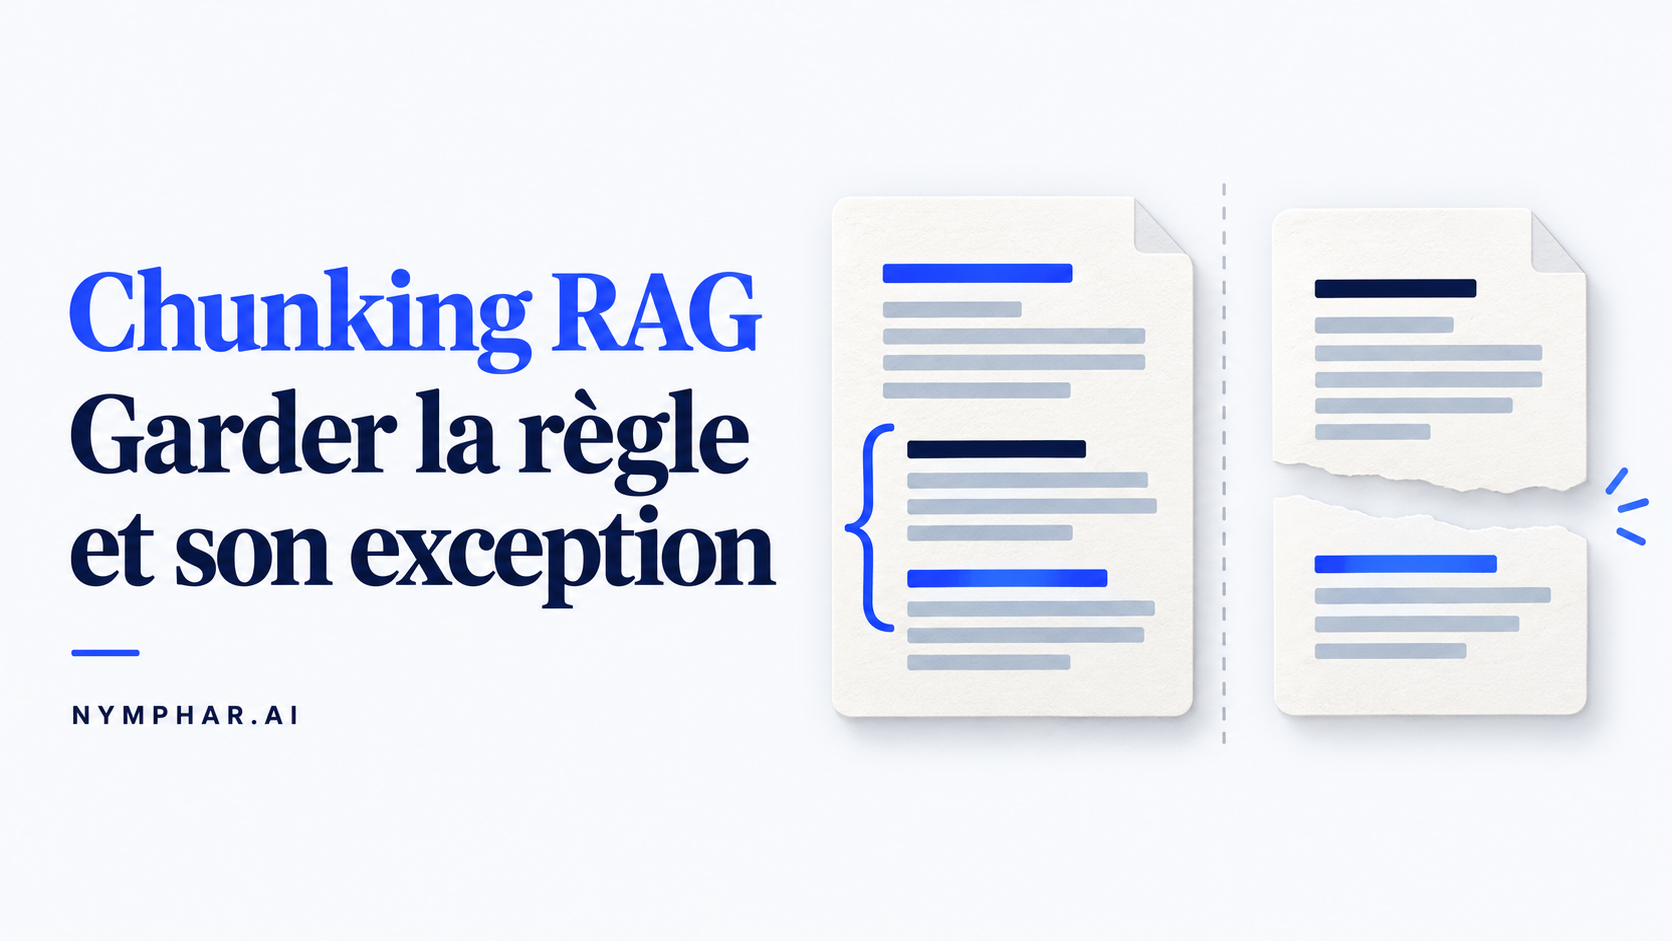
Le RAG associe recherche de documents et génération de réponse. Avant la recherche, le découpage transforme généralement les documents en passages, ou chunks. Chacun devient une unité que le moteur peut classer. Une frontière peut séparer une règle, sa condition et l’exception qui en change l’application.
Trois réglages ont des effets différents :
- La taille détermine la quantité de texte dans un passage.
- Le chevauchement, ou overlap, reprend une partie de la fin d’un passage au début du suivant.
- La structure utilise des frontières du document, par exemple les paragraphes ou les sections, plutôt qu’une longueur seule.
Microsoft décrit ces approches et précise que le contenu et l’usage influencent le réglage. Ses valeurs de départ en tokens ne constituent pas un optimum pour notre corpus. Guide de découpage Azure AI Search.
Un quatrième réglage intervient ensuite : le nombre de résultats retenus et la place laissée à leur contenu. Les passages peuvent être bien classés mais partiellement coupés lors de l’assemblage. C’est ce dernier texte qu’il faut inspecter avant d’accuser le découpage.
Commencer par la règle et son exception
Le jeu fourni contient une politique de déplacements entièrement inventée. Ses montants servent uniquement à examiner la recherche : ils ne sont pas des recommandations de remboursement.
À la question « Quel plafond de remboursement pour un hôtel à Paris pendant un salon professionnel ? », deux extraits sont attendus :
Le plafond ordinaire de remboursement d’un hôtel à Paris est de 140 euros par nuit.
Pendant un salon professionnel, ce plafond passe à 190 euros par nuit si le responsable a donné son accord écrit avant la réservation.
Avec des blocs fixes de 48 mots sans chevauchement, le premier résultat contient la règle ordinaire, sans l’exception. Regarder uniquement ce résultat ferait croire que le découpage a perdu la condition du salon.
Or le deuxième résultat contient l’exception entière. Les deux passages tiennent dans notre contexte final de 120 mots. La recherche fournit donc déjà les portions nécessaires pour cette question. Passer à 96 mots réunit les deux dans le premier passage, mais ne récupère ici aucun fait supplémentaire dans le contexte final.
Cette différence conduit à un diagnostic précis : si une réponse générée à partir de ce contexte oublie encore le salon ou l’accord écrit, la taille des passages n’est pas la seule piste à examiner. Il faut aussi contrôler les instructions, la lecture des preuves et la génération. Notre atelier s’arrête avant cette étape.
Comparer à budget constant, avec une unité explicite
Le corpus compte 432 mots, répartis dans trois documents fictifs : déplacements, matériel et formation. Cinq questions demandent chacune deux portions de preuve. Une sixième pose une question dont la réponse est absente du corpus.
Le script compare trois configurations contrôlées : 48 mots sans chevauchement, 96 mots sans chevauchement, puis 48 mots avec un chevauchement de 16. Une quatrième variante, par paragraphes, sert d’exploration structurelle ; elle change aussi la distribution des tailles, donc elle ne permet pas d’isoler l’effet de la taille seule.
Pour toutes les variantes, les questions, le moteur, les filtres FR et current, le maximum de trois résultats et le budget de 120 mots restent identiques. Le script reconstruit un index pour chaque découpage, classe les passages avec BM25 puis prend leur texte dans l’ordre du classement. Il coupe le dernier passage lorsque le budget est atteint. Les références attendues restent côté évaluateur et ne servent pas à classer les résultats.
SQLite FTS5 est ici un moteur de recherche par les termes du texte, sans synonymes ni embeddings. Sa fonction bm25() attribue les scores utilisés pour le classement. Le même moteur est conservé, mais découper différemment son index peut aussi modifier les scores et l’ordre. Documentation FTS5 et BM25.
Un mot de cet atelier est une suite séparée par des blancs, comptée avec str.split(). 48 mots ne signifie pas 48 tokens. De même, le splitter récursif LangChain mesure par défaut la longueur en caractères avec len ; la valeur d’un paramètre chunk_size ne suffit pas à connaître son unité. Paramètres du splitter récursif.
Dans votre application, mesurez les tokens avec le tokenizer du modèle et comptez aussi les titres, identifiants, instructions et questions présents dans la requête finale. Notre budget porte uniquement sur le corps des passages, sans titre préfixé ; il ne simule pas le coût complet d’un appel.
Quand doubler la taille ne récupère pas l’exception
La question sur le train demande la classe autorisée pour un déplacement de moins de quatre heures et l’exception liée au prix. La référence fictive impose la seconde classe, mais autorise la première si elle coûte au plus le prix de la seconde pour le même trajet.
Le résultat dépend de la frontière et de ce qui reste après assemblage :
| Configuration |
Observation sur la question train |
| 48 mots, sans chevauchement |
La règle est couverte, mais seulement 14 des 22 mots de l’exception sont présents. |
| 96 mots, sans chevauchement |
Le premier passage prend 96 mots du budget. Le deuxième est coupé à ses 24 premiers mots : l’exception reste en dehors du contexte final. |
| 48 mots, chevauchement de 16 |
Les portions de règle et d’exception sont intégralement couvertes, avec 32 occurrences de mots-source répétées dans les 120 mots préparés. |
Dans la variante de 96 mots, l’exception figure bien dans un résultat retrouvé avant limitation. C’est la consommation du budget qui l’empêche d’arriver jusqu’au contexte final. Une inspection des résultats bruts aurait donc attribué au moteur une information que l’étape suivante retire.
Le chevauchement résout ce cas du fichier, mais utilise de la place pour répéter des portions de source. L’atelier ne déduplique pas ces répétitions. Si votre application le fait, conservez ce comportement entre variantes et mesurez son effet séparément.
Ce que les résultats mesurent exactement
Pour chaque portion de preuve annotée, le contrôle vérifie que toutes ses positions dans le document source figurent parmi les passages conservés. Une preuve peut être répartie entre plusieurs passages. Le contrôle ne comprend pas le sens, ne vérifie pas leur bonne interprétation et ne prouve pas qu’un modèle les reliera correctement.
Sur les cinq questions répondables de cet exercice :
| Variante |
Contextes couvrant toutes les portions requises |
Portions couvertes |
Mots préparés |
| 48 mots, chevauchement 0 |
4 sur 5 |
9 sur 10 |
600 |
| 96 mots, chevauchement 0 |
3 sur 5 |
8 sur 10 |
600 |
| 48 mots, chevauchement 16 |
5 sur 5 |
10 sur 10 |
600 |
| Paragraphes, exploration |
5 sur 5 |
10 sur 10 |
600 |
Les 600 mots correspondent à cinq contextes préparés de 120 mots, sans appel de modèle. Avec chevauchement, 101 occurrences répètent une position source déjà présente dans le contexte de la même question, en cumulant les cinq questions. La répétition d’un mot courant à deux endroits différents du document n’est pas comptée comme cette redondance.
Ces nombres ne classent pas des stratégies pour la production. Le corpus a été rédigé pour rendre visibles règles, exceptions et frontières ; les questions reprennent souvent ses mots. Il n’y a ni échantillon représentatif, ni estimation de coût d’embeddings, ni mesure de réponse générée. Les paramètres ont été fixés avant la première exécution, sans optimiser ensuite les valeurs sur ces sorties.
La question sans réponse reste séparée des cinq questions répondables. Retrouver un passage pour elle ne démontre pas qu’une réponse existe. Le fichier n’accorde pas une réussite artificielle parce qu’un modèle, qui n’a pas été exécuté, aurait supposément refusé de répondre.
Rejouer le diagnostic localement
Prérequis : Python 3.10 ou supérieur avec SQLite FTS5 disponible. Aucun compte, clé API ou paquet externe n’est nécessaire. Si FTS5 manque dans votre distribution Python, le script s’arrête avec une erreur explicite plutôt que de remplacer silencieusement le moteur.
Téléchargez et décompressez l’atelier complet, ou récupérez dans un même dossier atelier.py et cas_fr.json. Consultez le README pour les unités, les limites et les options.
python3 atelier.py --self-test
python3 atelier.py --data cas_fr.json --output mon-rapport.json
Le premier appel contrôle l’évaluateur avec des erreurs volontaires. Le second exécute les découpages, la recherche et l’assemblage. Les résultats de référence proviennent d’une exécution réelle sous Python 3.14.7 et SQLite 3.53.4.
Dans le rapport, comparez pour la question hôtel hits_before_budget, puis context et facts. Vous devez retrouver la règle et l’exception dans le contexte de 48 mots sans chevauchement, même si le premier passage seul ne suffit pas. Faites ensuite la même lecture pour le train : le résultat de 96 mots doit montrer l’effet de la coupure du deuxième passage.
Les horodatages changent entre exécutions. Ce sont les configurations, identifiants, portions couvertes et textes retenus qu’il faut comparer. Une réussite des autocontrôles valide leur comportement prévu ; elle ne remplace pas la relecture des annotations.
Choisir le prochain changement sur votre corpus
Avant de réindexer, prenez des questions dont les références ont été vérifiées et archivez le contexte réellement transmis par votre application. Classez l’échec : preuve absente du document, fragment non retrouvé, fragment retiré par le budget, ou réponse fausse malgré des preuves présentes.
Testez ensuite une seule modification contrôlée : taille, chevauchement ou frontières structurelles. Conservez questions, filtres, recherche, reclassement et budget comparables. Relisez les cas qui gagnent ou perdent une exception, une date ou une unité ; une moyenne seule ne dit pas quelle consigne sera mal appliquée.
Un passage peut également perdre l’identité du produit ou la période à laquelle il appartient. Ajouter du contexte explicatif au passage est une autre approche : Anthropic décrit cette méthode dans son travail sur le Contextual Retrieval, publié en septembre 2024. Elle diffère d’un chevauchement et n’a pas été testée dans cet atelier. Méthode Contextual Retrieval.
L’effort d’adoption à chiffrer comprend la nouvelle indexation, les embeddings éventuels, le stockage des passages et la revalidation des questions. Mesurez ces coûts et délais sur votre système ; le résultat local ne les estime pas. Gardez l’ancienne configuration disponible pendant l’essai.
Pour préparer les références, utilisez notre guide d’annotation des questions et preuves RAG. Pour isoler ensuite un problème de classement, consultez la recette de comparaison de rerankers. Après le choix documentaire, évaluez aussi la réponse finale : disposer de la bonne exception dans le contexte reste une condition à vérifier, pas une garantie de réponse juste.