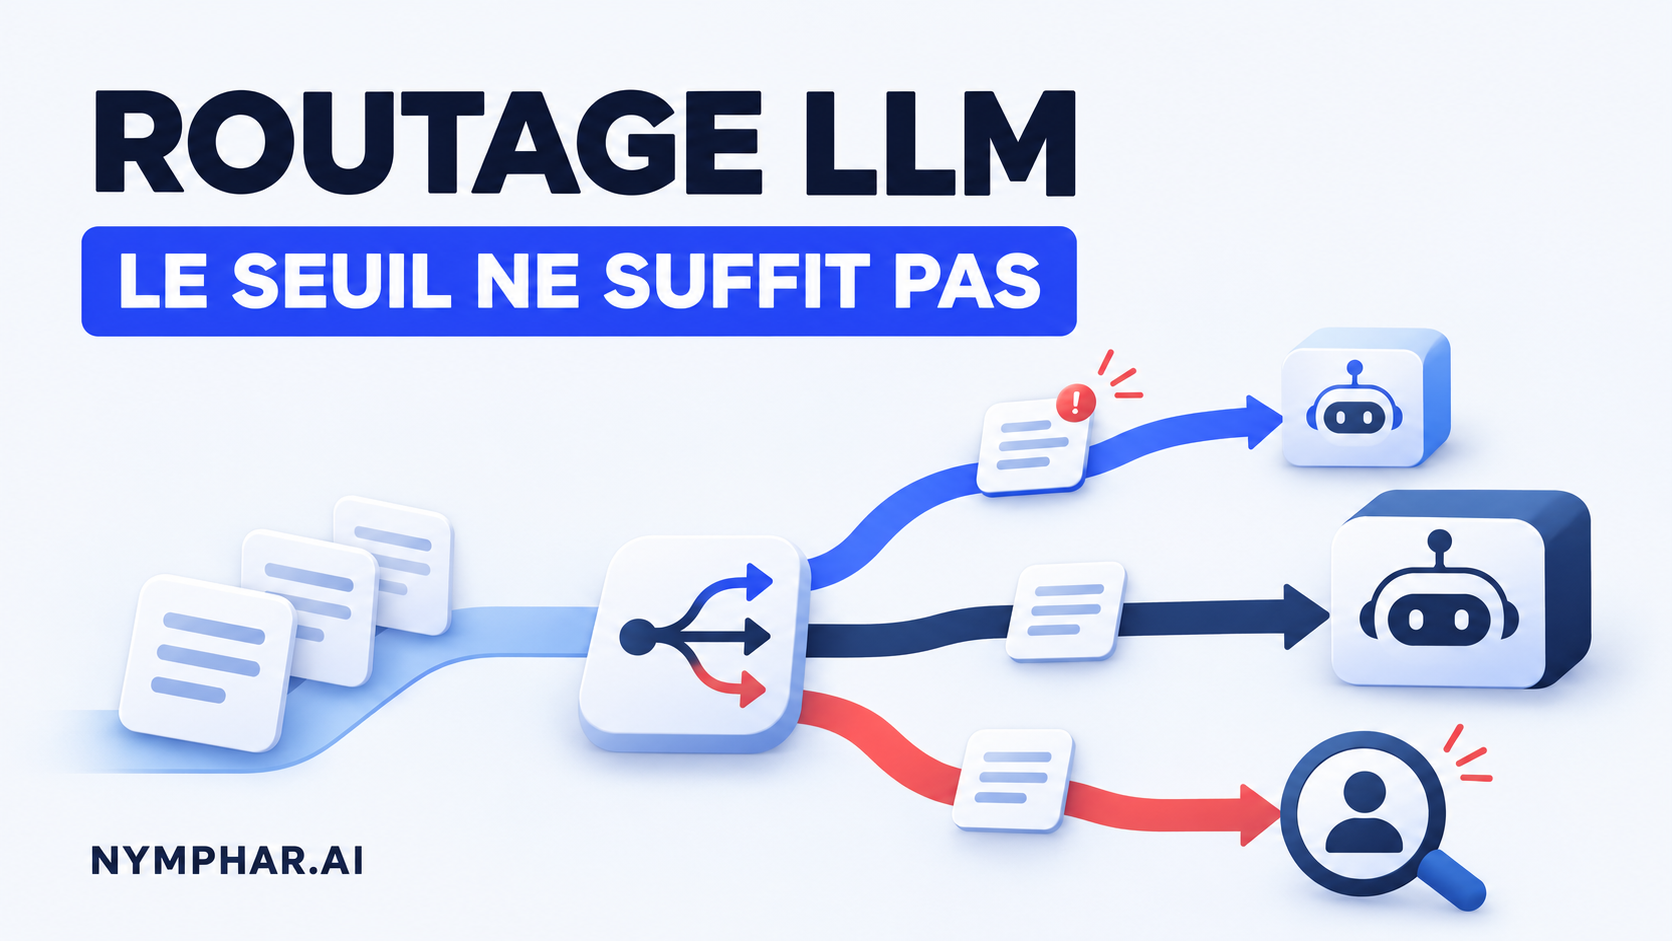
Un petit modèle classe les demandes du service client. Les réponses assorties d’un score élevé restent dans cette première voie ; les autres passent à un modèle plus capable. L’équipe compte les escalades et voit moins d’appels au grand modèle. Elle ne sait pourtant pas encore combien de réponses fausses ont évité ce contrôle.
Le routage LLM doit se juger sur ces erreurs conservées, sur le résultat après escalade et sur le coût de toute la chaîne. Un seuil ne remplace aucun de ces trois contrôles.
L’exercice proposé ici teste une règle de décision sur huit tickets fictifs. Textes, prédictions et scores ont été rédigés pour rendre ses limites visibles. Le programme a réellement été exécuté ; aucun modèle n’a été appelé. Il permet de comprendre et de reproduire le mécanisme, sans constituer un benchmark ni choisir un fournisseur.
Choisir avant la réponse ou escalader après
Deux architectures sont souvent désignées par le même mot.
Un routeur avant génération examine la demande et choisit le modèle qui répondra. RouteLLM, dans sa version de recherche de février 2025, apprend notamment à estimer si le modèle plus capable devrait battre l’autre. Il ne commence pas par obtenir une réponse de chacun.
Une cascade fait d’abord travailler un modèle, puis décide si une autre passe est nécessaire. C’est notamment le principe étudié dans FrugalGPT, publié en 2023. Le premier appel est déjà consommé lorsqu’on déclenche le second. L’entrée du contrôle peut inclure la réponse produite, une vérification ou un score.
Notre exercice porte sur cette seconde architecture. La cascade est intéressante quand la première réponse fournit un signal utile pour décider de la suite. Si la décision peut déjà être prise à partir d’une règle simple sur la demande, payer cette première passe n’est pas nécessairement pertinent.
Même le sens d’un seuil dépend du score. Dans RouteLLM, relever le seuil de victoire du grand modèle favorise davantage le petit. Dans notre exercice, relever le seuil d’acceptation du petit modèle conserve moins de ses réponses. Copier un nombre d’un routeur vers un autre sans lire ce que mesure son score peut inverser la politique.
Un score élevé peut accompagner la mauvaise classe
Un score de 0.96 n’établit pas, à lui seul, que cette réponse a 96 % de chances d’être correcte. La documentation scikit-learn sur la calibration explique comment comparer des probabilités annoncées et des fréquences observées, sur des exemples indépendants de l’apprentissage du classificateur.
Ce travail ne se réduit pas à demander au LLM « es-tu sûr ? ». Il faut définir la réussite, disposer de références et vérifier le signal sur les demandes concernées. Un score de classe, une préférence entre deux modèles et une estimation de justesse ne mesurent pas la même chose.
Pour un service client français, une bonne moyenne sur des questions générales en anglais ne répond pas à la question utile : quelles demandes de désabonnement, de suivi ou de remboursement partent dans la mauvaise file ? Une sortie structurée valide peut toujours contenir la mauvaise catégorie.
Le cas central : huit tickets et trois destinations
Le fichier contient une catégorie attendue, une prédiction fictive, un score fictif et un indicateur review_required. Cet indicateur représente une règle métier déjà déterminée : dans cet exemple, les changements d’adresse et remboursements exigent une revue humaine. Le script ne sait pas détecter ces demandes dans du texte libre. La fiabilité de cette détection serait un travail supplémentaire en production.
| ID |
Demande, abrégée |
Référence |
Prédiction fictive |
Score |
Revue requise |
| T01 |
Où est mon colis ? |
suivi |
suivi |
0.98 |
Non |
| T02 |
Changer l’adresse avant départ |
modification |
suivi |
0.97 |
Oui |
| T03 |
Duplicata de facture |
facturation |
facturation |
0.93 |
Non |
| T04 |
Rembourser la livraison |
remboursement |
remboursement |
0.99 |
Oui |
| T05 |
Arrêter les emails publicitaires |
communication |
resiliation |
0.96 |
Non |
| T06 |
Résilier à la fin du mois |
resiliation |
resiliation |
0.89 |
Non |
| T07 |
Colis livré mais non reçu |
reclamation |
suivi |
0.70 |
Non |
| T08 |
Rembourser un double débit |
remboursement |
remboursement |
0.92 |
Oui |
La première politique ne regarde que le score. À partir de 0.90, elle conserve la prédiction ; en dessous, elle demande une seconde passe au grand modèle. Six tickets restent au petit modèle. Deux sont mal classés : T02 et T05.
La seconde politique applique d’abord la règle de revue humaine, puis le seuil aux autres demandes. T02, T04 et T08 vont à un humain, quel que soit leur score. Trois prédictions restent au petit modèle ; T05 est toujours fausse. Le contrôle métier traite un risque défini, sans rendre toutes les autres réponses correctes.
Relever le seuil ne retire pas forcément l’erreur gênante
Avec la revue humaine prioritaire, le programme produit :
| Seuil inclusif du petit modèle |
Prédictions conservées |
Vers le grand modèle |
Vers un humain |
Erreurs connues conservées |
| 0.90 |
3 |
2 |
3 |
T05 |
| 0.95 |
2 |
3 |
3 |
T05 |
| 0.98 |
1 |
4 |
3 |
Aucune dans ces fixtures |
À 0.95, le duplicata de facture, correctement classé avec 0.93, part en seconde passe. L’erreur de désabonnement reste acceptée avec 0.96. Le seuil a déplacé du travail sans corriger ce cas.
À 0.98, cette erreur est enfin escaladée, mais cela ne prouve pas que le grand modèle la corrigera. Ses réponses ne figurent pas dans l’exercice. Le résultat final, la qualité du traitement humain et le coût réel restent donc null dans le rapport. Ces huit cas construits n’estiment ni une fréquence de production ni un seuil optimal.
La décision devient plus précise : faut-il modifier le seuil, ajouter une distinction communication/résiliation au classificateur, ou réserver cette catégorie à une autre voie ? Un compteur global d’escalades ne permet pas de trancher.
Reproduire la règle localement
Téléchargez les tickets fictifs et le programme Python dans le même dossier. Python 3 et sa bibliothèque standard suffisent. Le script lit le CSV placé à côté de lui ; il ne contacte aucun service.
mkdir recette-routage
cd recette-routage
curl -fsSLO https://nymphar.ai/ressources/routage-petit-modele-llm/tickets-fictifs.csv
curl -fsSLO https://nymphar.ai/ressources/routage-petit-modele-llm/recette-routage.py
python3 recette-routage.py > resultat-local.json
Le rapport de référence conserve les décisions complètes. Cherchez threshold_inclusive: "0.95" avec use_review_rule: true : les compteurs valent small: 2, large: 3, human: 3, et known_errors_kept contient T05.
Le programme vérifie aussi le score exactement égal au seuil, le score juste inférieur, l’absence de score et la priorité de la revue humaine. Les valeurs non numériques, non finies ou hors de [0, 1] sont refusées. Un score absent déclenche la seconde passe ; une erreur de données n’est pas transformée silencieusement en réponse acceptée.
Modifiez la prédiction de T05 dans une copie du CSV pour observer la différence entre corriger une réponse et seulement modifier sa destination. Cela reste une manipulation de fixture, pas l’amélioration d’un modèle entraîné.
Passer de cet exercice à une décision d’équipe
Commencez par fixer le contrat de sortie : ici une catégorie, aucune réponse envoyée au client et aucune action exécutée. Classement, rédaction et remboursement sont des décisions distinctes. La revue humaine obligatoire doit provenir d’une règle métier ou d’un contrôle dont la couverture est évaluée ; ce champ ne se remplit pas tout seul.
Constituez ensuite un jeu représentatif avec références annotées avant de regarder les scores. Conservez les textes complets et les erreurs par catégorie. Si vous utilisez un golden dataset, réservez une partie des exemples au choix du seuil et une autre à l’évaluation finale. Sélectionner le seuil et annoncer sa qualité sur les mêmes demandes donne une évaluation trop favorable.
Sur ce même jeu autorisé, recueillez les réponses réelles des deux modèles et du contrôle retenu. Comparez le petit seul, le modèle de référence seul et la cascade. Les exemples transmis au grand modèle doivent respecter les contraintes de données et d’hébergement prévues pour ce second service. Ne supposez ni qu’il est toujours meilleur, ni que la première classification peut déclencher une action sans autre autorisation.
Choisissez enfin une politique à partir des erreurs que l’équipe peut accepter dans chaque catégorie. Mesurez séparément les réponses conservées fausses, les bonnes réponses escaladées, les erreurs après escalade et les cas réservés aux humains. Une panne du second service doit rester un état visible. Revenir au petit modèle après une erreur technique modifie la politique de qualité ; ce n’est pas une simple réparation transparente.
Compter le coût de toute la trajectoire
Pour chaque demande de la cascade, le coût comprend la première passe, le contrôle, la seconde passe éventuelle et les reprises. La dépense du petit modèle ne disparaît pas quand on escalade. Les demandes envoyées au grand peuvent aussi être plus longues ou plus complexes que la moyenne : le nombre d’appels évités ne se convertit pas directement en pourcentage d’économie.
Gardez dans les traces le modèle et sa version, les tokens réellement facturés, les tentatives, le coût du vérificateur, les erreurs et les délais. Comparez le total à la référence sur les mêmes demandes. Mesurez les délais de bout en bout ; additionner deux latences moyennes ne donne pas le délai du 95e percentile de la cascade. Le temps de revue humaine se suit séparément.
Aucun tarif ni gain universel ne permet de choisir le seuil. Dans l’exercice, les appels et coûts restent absents. Dans un pilote réel, les conditions du fournisseur, le cache, les longueurs de sortie et les reprises doivent être enregistrés avec les dépenses observées.
Quand conserver une seule voie
Gardez un seul modèle quand le contrôle n’aide pas à séparer les demandes, quand son coût annule l’intérêt de la cascade ou quand la règle change trop souvent pour être évaluée. Une tâche à conséquence importante peut aussi rester sous validation humaine, même avec un score élevé.
Le bon point de départ n’est pas « quel seuil donne le plus de petits modèles ? ». C’est une liste d’erreurs non escaladées que l’équipe sait examiner. Si cette liste reste problématique, le routage n’est pas prêt à être élargi.